L’Europe impose désormais une identification pour tous les contenus produits par les intelligences artificielles génératives, et peu à peu, tous les acteurs du secteur se plient à ces exigences. Si une image peut aisément être associée à une IA par ses métadonnées, c’est plus compliqué pour le texte brut produit par les grands modèles de langage (LLM) utilisés par toute l’industrie. Dans ce cas de figure, tout le monde semble adopter à peu près la même stratégie et après Anthropic cet été, c’est au tour d’OpenAI de présenter sa solution.

Claude ajoute un filigrane invisible à ses textes pour se conformer à l'AI Act européen
Le créateur de ChatGPT a imaginé textGrain, un système très sophistiqué qui reprend le fonctionnement général de SynthID de Google, utilisé dans Claude. Pour faire (très) simple, le modèle est ajusté de telle manière que son choix des mots ne se fasse plus seulement en fonction de leur pertinence. En temps normal, l’IA sélectionne chaque mot en fonction de la probabilité qu’il soit retenu dans le contexte en cours, avec une part d’aléatoire qui donne ce côté parfois inattendu aux productions des LLM. Avec ces mécanismes d’identification en place, la probabilité associée à une part de hasard n’est plus le seul critère. Le modèle va aussi choisir des mots qui sont censés attester que le texte n’a pas été produit par un humain.
En théorie, cette entorse sur la distribution des mots est censée être invisible, et le texte généré doit rester cohérent et conserver son sens. OpenAI revendique plusieurs améliorations par rapport à la solution concurrente, et promet des variations infimes. Dans les mesures fournies par l’entreprise, l’écart entre la production de GPT-6 Astra sans le marquage et la version avec filigrane est en général de l’ordre de quelques dixièmes de points. Cela signifie que, d’après ces chiffres, la nouveauté sera insignifiante, tout en permettant effectivement d’identifier la production de ChatGPT.
La méthode a ses limites. La reconnaissance a besoin d’un texte suffisamment long pour être fiable : le taux de réussite n’est que de 80 % pour 200 jetons1, alors qu’il passe à 95 % en doublant la taille du contenu. Par ailleurs, la détection est bien plus efficace avec un écrit psychologique qu’avec des mathématiques, qui empêchent bon nombre de substitutions. Enfin et surtout, retoucher légèrement la production du modèle est suffisant pour brouiller les pistes. OpenAI indique ainsi qu’il suffit de remplacer 10 % des mots pour réduire l’identification d’environ 30 points, tandis que la méthode s’effondre en changeant un quart des mots : il ne reste plus que 7 % de chances de détecter l’origine sur 200 jetons, par exemple.
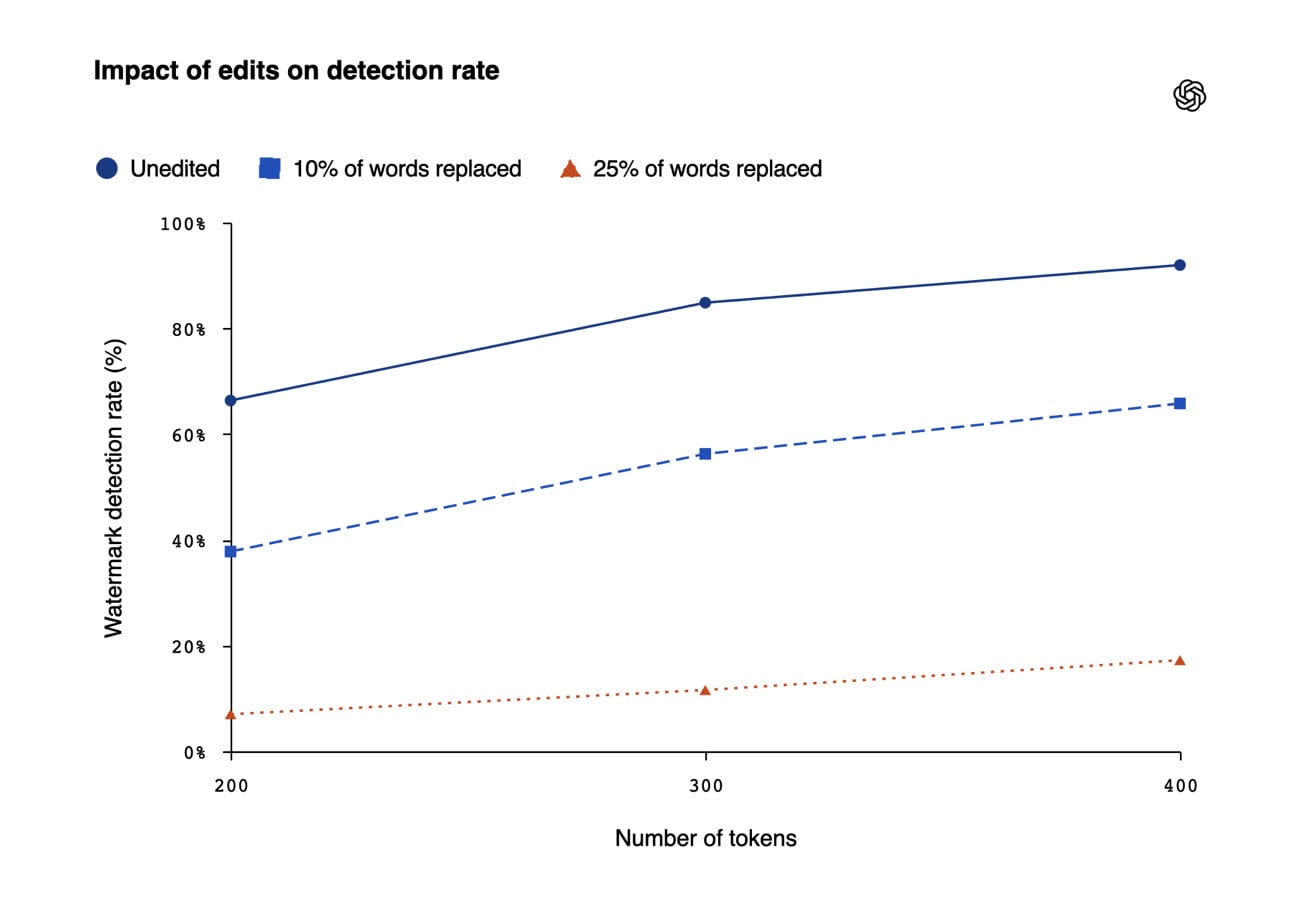
Malgré ces imperfections, c’est l’option retenue pour répondre aux exigences de l’Union européenne et OpenAI va la déployer dans les prochaines semaines. Contrairement à Anthropic, qui a mis en œuvre la mesure dans le monde entier, seuls les utilisateurs européens de ChatGPT et Codex y auront droit. Si cela pourra changer par la suite, ce déploiement régional permettra d’évaluer l’effet réel et à grande échelle du marquage des textes. Pour l’API, qui permet d’accéder directement aux modèles et de payer par jeton, textGrain est disponible dès aujourd’hui, mais uniquement sur demande. Le contenu généré par ce biais ne sera pas altéré par défaut, ce sera à l’utilisateur de prendre ses responsabilités.
Dans un premier temps, OpenAI ne va pas donner accès à un outil d’identification, comme l’entreprise l’a fait pour l’image et l’audio. Seuls quelques chercheurs et organisations approuvées par ses soins pourront accéder à cet outil capable de repérer les marquages des contenus. À terme, la firme de Sam Altman promet de l’ouvrir plus largement, sans s’engager sur un calendrier.
-
Les LLM fonctionnent sur la base de jetons, qui ne recouvrent pas exactement un mot. L’équivalent en mots dépend des langues, mais cela correspond à environ 140 mots en français. ↩︎